OpenAI가 샤딩 없이 PostgreSQL을 확장한 사례
이 글은 OpenAI의 PostgreSQL 확장 사례를 읽고 정리한 글이다. 원문은 Bohan Zhang이 2026년 1월 22일 공개했다.
사용자 수·처리량·장애·지연 수치는 원문의 발표 시점과 측정 범위에 속한다. 내가 해당 인프라를 운영하거나 같은 규모를 재현한 결과는 아니다. 아래의 ‘현재’와 ‘개발 중’도 그 발표 시점을 가리킨다.
ChatGPT 출시 이후 OpenAI의 PostgreSQL 부하는 1년 만에 10배 이상 증가했다. 사용자 수만으로 샤딩 필요성을 결정할 수는 없다. OpenAI는 읽기 중심의 기존 부하를 최적화하고, 쓰기 중심 부하 일부를 다른 시스템으로 옮겼다고 설명한다.
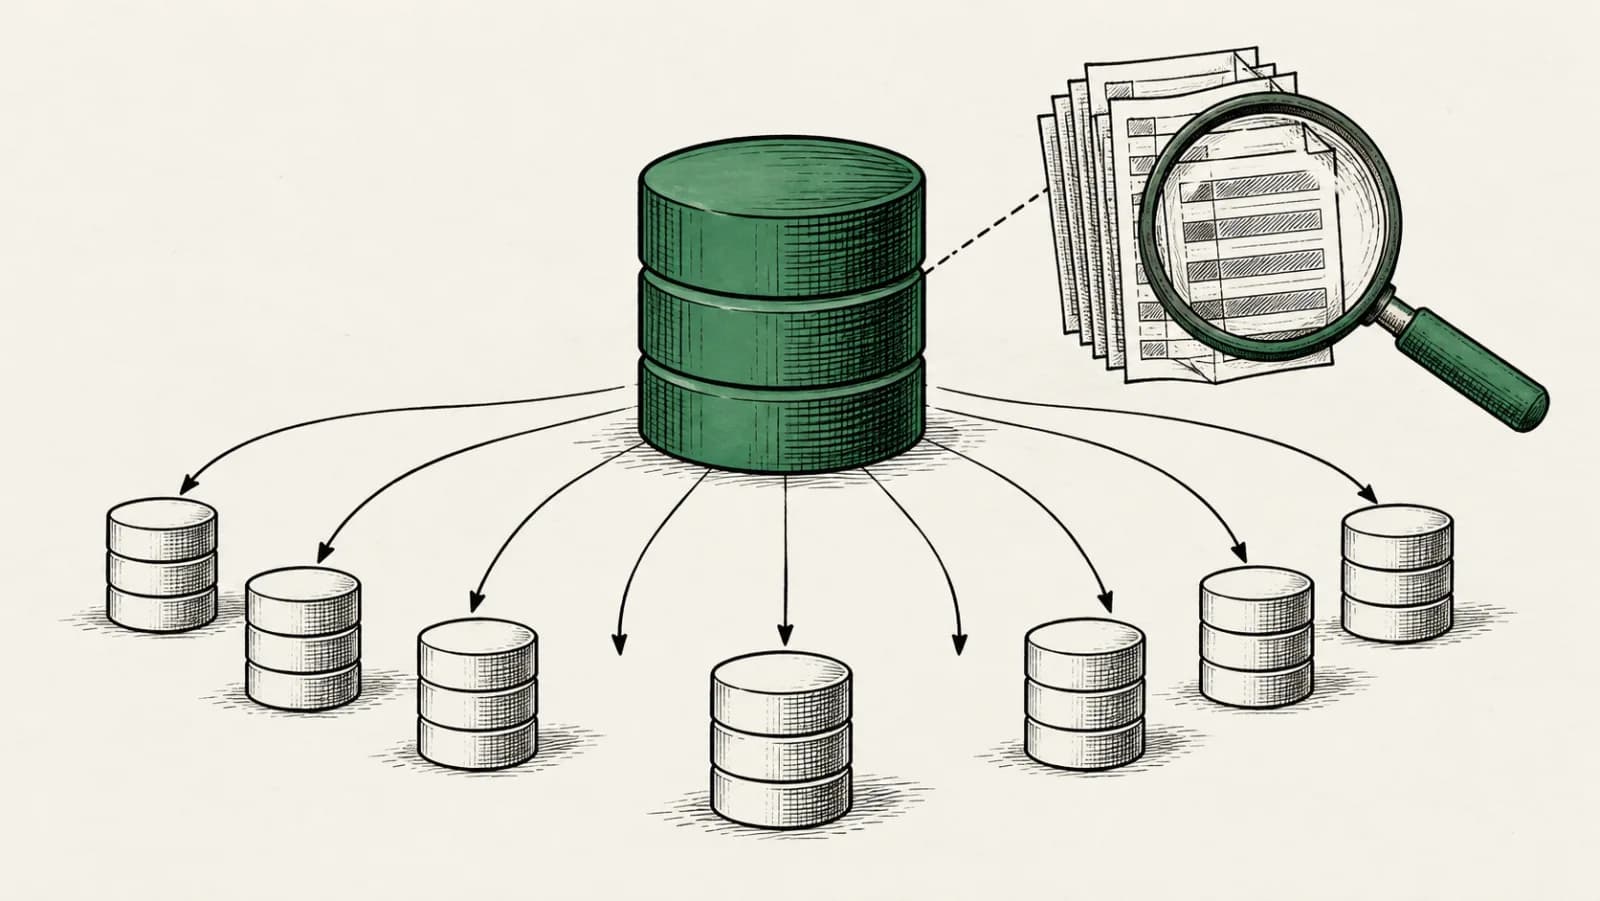
OpenAI의 구성은 단일 Azure PostgreSQL Flexible Server Primary와 전 세계 여러 리전에 분산된 약 50개의 Read Replica가 중심이다. 이 구성으로 초당 수백만 QPS를 처리하며 8억 명의 사용자를 지원한다.
이 글은 OpenAI가 이 구성을 운영하며 겪은 문제와 해결책을 정리한다. PostgreSQL의 고질적인 약점인 MVCC도 함께 다룬다.
샤딩하지 않은 이유
현재 PostgreSQL은 샤딩되지 않은 상태다. 단일 Primary가 PostgreSQL로 들어오는 모든 쓰기를 처리한다. 다만 단일 DB 인스턴스 하나가 OpenAI의 모든 데이터 처리를 담당한다는 의미는 아니다.
원문은 기존 애플리케이션을 바꾸는 비용과, 읽기 중심 부하에서 아직 확보한 여유를 이유로 든다.
기존 워크로드를 샤딩하려면 수백 개의 애플리케이션 엔드포인트를 바꿔야 한다. 이 작업에는 수개월~수년이 걸릴 수 있다. 대신 OpenAI는 기존 PostgreSQL의 쓰기 부하를 늘리지 않으면서 이후 전환 가능성을 열어 두었다.
- 샤딩 가능한 쓰기 중심 워크로드는 이미 Azure CosmosDB로 이전 중
- 기존 PostgreSQL에 새 테이블은 더 이상 추가하지 않음
- 신규 워크로드는 기본적으로 샤딩 시스템을 사용
- 향후 샤딩 PostgreSQL 또는 분산 DB로의 전환 가능성은 열어둠
PostgreSQL의 고질적 약점: MVCC
OpenAI가 겪은 많은 문제의 근본 원인 중 하나는 PostgreSQL의 MVCC 구현 방식이다. MVCC는 Multi-Version Concurrency Control의 약자다.
The Part of PostgreSQL We Hate the Most는 이 비용을 비판적으로 분석한 글이다. Bohan Zhang과 CMU Andy Pavlo 교수가 함께 썼다. 이 절은 해당 글과 PostgreSQL 문서의 설명을 함께 정리했다.
MVCC의 기본 동작
MVCC는 데이터를 수정할 때 기존 행을 덮어쓰지 않고 새 버전을 복사해서 만든다. 덕분에 일반적인 조회와 행 갱신의 경합을 줄일 수 있다. 다만 명시적으로 행을 잠그는 조회나 강한 테이블 잠금은 여전히 대기할 수 있다.
PostgreSQL의 구현 방식은 다른 DBMS와 비교하면 몇 가지 심각한 문제를 안고 있다.
문제 1: 버전 전체 복사 (Version Copying)
일부 컬럼만 바꿔도 새 행 버전을 만들기 때문에 쓰기 비용이 커질 수 있다. 다만 변경하지 않은 외부 TOAST 값은 재사용할 수 있어서, 모든 컬럼의 큰 데이터까지 항상 복사되지는 않는다. 이 동작은 PostgreSQL TOAST 문서가 설명한다.
CMU 글은 MySQL·Oracle의 이전 버전 보관 방식과 비교한다. 이 방식 차이로 특정 쓰기의 비용은 줄어들 수 있다. 하지만 전체 성능의 우열은 부하와 인덱스 구성에 따라 따로 측정해야 한다.
문제 2: 테이블 비대화 (Table Bloat)
회수할 수 있는 구버전(Dead Tuple)이 쌓이면 테이블이 커지고 스캔 비용도 늘어날 수 있다. 이전 판에서 든 ‘유효 데이터 10GB와 구버전 40GB’는 설명을 위한 가정이며 실제 측정값이 아니다. 실제 읽기량은 저장 페이지, 실행 계획, 캐시 상태를 함께 보고 확인해야 한다.
일반 VACUUM은 회수한 공간을 주로 테이블 안에서 다시 쓰게 한다. 다만 테이블 끝의 빈 페이지는 OS에 반환하는 예외가 있다.
테이블을 축소하는 VACUUM FULL은 재작성과 강한 잠금이 필요하다. pg_repack 같은 재구성 도구도 별도 실행 조건을 검토해야 한다. 이 차이는 PostgreSQL VACUUM 문서를 기준으로 구분할 수 있다.
문제 3: 인덱스 유지 비용 (Secondary Index Maintenance)
HOT(Heap-Only Tuple) 조건이 맞으면 새 행 버전에 맞춘 인덱스 유지 비용이 줄어든다. 약 46%는 CMU 글이 분석한 OtterTune 고객 데이터베이스의 평균이다. 모든 PostgreSQL 설치나 OpenAI에 해당하는 비율은 아니다.
나머지 약 54%라는 값도 같은 표본에 한정된다. 내 테이블에 적용하려면 공식 HOT 문서의 조건과 테이블 통계를 먼저 확인해야 한다.
Uber의 2016년 전환 기록도 쓰기와 인덱스 비용을 설명한다. 다만 그 당시 부하와 버전의 사례라서, 오늘의 모든 서비스가 같은 결정을 해야 한다는 근거로 쓰지는 않겠다.
문제 4: Autovacuum 관리 어려움
기본 비율 설정인 autovacuum_vacuum_scale_factor는 0.2다. 하지만 이 값만으로 실행 시점을 설명할 수는 없다. 기본 임계값, 테이블별 설정, 버전에 따른 최대 임계값, 삽입·트랜잭션 ID 순환 방지 조건 등을 함께 봐야 한다.
이전 판에서 든 ‘1억 행에서 약 2,000만 변경’은 비율을 설명하기 위한 단순 계산이다. 모든 환경의 실행 시점을 뜻하지는 않는다. 실제 설정은 PostgreSQL 자동 VACUUM 설정을 사용 버전에 맞춰 확인해야 한다.
오래 실행되는 트랜잭션이 Autovacuum을 차단하면 Dead Tuple이 계속 쌓여 쿼리가 느려진다. 느려진 쿼리는 다시 Autovacuum을 막아 악순환이 생긴다.
OpenAI가 직면한 문제들과 해결책
이하 아홉 항목은 OpenAI 원문의 최적화 과정 요약이다. 설정값과 정책을 일반 권장값으로 옮기지 않도록 주의해야 한다.
1. Primary 부하 집중
쓰기 노드가 하나뿐이라 대규모 쓰기 스파이크가 오면 Primary가 빠르게 과부하 상태가 된다. 여기에 MVCC의 Write Amplification, Table Bloat, Autovacuum 튜닝 문제가 겹친다.
해결책
- 읽기 트래픽은 최대한 Replica로 오프로드
- 샤딩 가능한 쓰기 중심 워크로드를 CosmosDB로 이전
- 중복 쓰기를 유발하는 애플리케이션 버그 수정
- 트래픽 급증 완화를 위한 지연 쓰기(Lazy Write) 도입
- 백필 작업 시 엄격한 속도 제한 적용 (1주일 이상 걸리더라도 안정성 우선)
2. 고비용 쿼리
ORM이 12개 테이블을 조인하는 쿼리를 자동으로 생성했다. 이 쿼리는 트래픽이 몰릴 때마다 CPU를 대량 소모했다. 그 결과 ChatGPT와 API 전반이 느려지는 고심각도 장애(SEV)가 났다.
해결책
- 복잡한 다중 테이블 조인을 피하고, 불가피한 경우 조인 로직을 애플리케이션 계층으로 분리
- ORM이 생성하는 SQL을 반드시 직접 검토
idle_in_transaction_session_timeout등 타임아웃 설정으로 장기 유휴 쿼리가 Autovacuum을 차단하지 못하도록 통제
3. 단일 장애 지점(SPOF)
Primary가 다운되면 쓰기 전체가 실패하고 서비스 전반에 영향을 준다.
해결책
- 핵심 읽기 요청을 Replica로 오프로드해 Primary 다운 시에도 읽기는 유지 (SEV0 수준 장애 방지)
- 항상 동기화된 핫 스탠바이를 포함한 HA 모드로 운영, 장애 시 신속하게 스탠바이 승격
- 각 리전에 여유 용량을 가진 여러 Replica를 배치해 단일 Replica 장애가 리전 전체 장애로 이어지지 않도록 함
4. 워크로드 격리
신규 기능 출시로 비효율적인 쿼리가 유입되면 같은 인스턴스의 다른 핵심 서비스까지 느려진다.
해결책
- 요청을 고우선순위/저우선순위로 나눠 각각 전용 인스턴스로 라우팅
- 제품/서비스 간에도 동일하게 적용해 한 제품의 활동이 다른 제품 성능에 영향을 주지 않도록 격리
5. Connection 관리
인스턴스당 최대 커넥션 수에는 제한이 있다. Azure PostgreSQL 기준으로 5,000개다. 과거에는 커넥션 스톰으로 커넥션이 전부 소진된 사고도 있었다.
해결책
- PgBouncer를 프록시 계층으로 배포, 트랜잭션/문장 풀링 모드로 운영
- 커넥션 설정 시간을 50ms에서 5ms로 단축
- 각 Read Replica마다 전용 Kubernetes Deployment로 여러 PgBouncer Pod 운영
User Requests
    → Kubernetes Service
    → 각 Read Replica 전용 Kubernetes Deployment (PgBouncer Pod 여러 개)
    → Read Replica
- 프록시, 클라이언트, Replica를 동일 리전에 배치해 네트워크 오버헤드 최소화
- 유휴 타임아웃 등 PgBouncer 설정을 세심하게 튜닝
6. 캐시 미스 폭풍
캐시 적중률이 갑자기 떨어지면 대량의 요청이 PostgreSQL로 직접 들어와 CPU가 포화된다.
해결책
- 캐시 락(Cache Lock) 메커니즘 도입
- 동일 캐시 키에서 미스 발생 시 단 하나의 요청만 DB에서 데이터를 가져오고, 나머지는 캐시가 갱신될 때까지 대기
- 중복 DB 읽기를 줄이고 연쇄적인 부하 스파이크 차단
7. Read Replica 확장 한계
Replica 수가 늘어날수록 Primary는 모든 Replica에 WAL을 스트리밍해야 한다. 그래서 네트워크 대역폭과 CPU 부담이 커지고 복제 지연이 불안정해진다.
해결책
- Azure PostgreSQL 팀과 Cascading Replication 공동 개발 중
- 중간 Replica가 하위 Replica에 WAL을 릴레이하는 방식으로 100개 이상의 Replica까지 확장 가능
- 다만 페일오버 관리 등 운영 복잡성이 증가하는 트레이드오프가 있어 충분한 검증 후 프로덕션 적용 예정
Primary → WAL → Intermediate Replica(들) → WAL → Read Replica(들)
8. 트래픽 급증 대응 (Rate Limiting)
CPU, I/O, 커넥션이 빠르게 고갈된다. 원인은 특정 엔드포인트의 갑작스러운 트래픽 급증, 고비용 쿼리 폭증, 재시도 폭풍이다.
해결책
- 애플리케이션, 커넥션 풀러, 프록시, 쿼리 다중 레이어에서 Rate Limiting 적용
- 너무 짧은 재시도 간격으로 인한 Retry Storm 방지
- ORM 레이어에서 특정 쿼리 digest를 완전 차단하는 기능 추가
9. 스키마 변경 제한
컬럼 타입 변경 같은 작은 스키마 변경도 테이블 전체 재작성을 유발할 수 있다. 그래서 프로덕션에서 매우 위험하다.
해결책
- 테이블 전체 재작성이 필요한 변경 금지
- 스키마 변경에 5초 타임아웃 강제
- 인덱스 생성/삭제는 반드시
CONCURRENTLY옵션 사용 - 기존 PostgreSQL에 새 테이블 추가 금지 (신규 기능은 CosmosDB 등으로)
- 백필 시 엄격한 속도 제한 (1주일 이상 걸리더라도 안정성 우선)
결과
아래 표는 OpenAI가 발표한 결과다. 약 50개 복제본을 운영한 해당 구성의 관측치다. 단일 인스턴스의 보장 성능이나 내 서비스의 측정 결과가 아니다.
| 지표 | 수치 |
|---|---|
| p99 클라이언트 사이드 지연시간 | 두 자릿수 밀리초(ms) |
| 가용성 | Five-nines (99.999%) |
| 12개월간 SEV-0 장애 | 단 1건 |
| Read Replica 수 | 약 50개 (복제 지연 거의 0) |
유일한 SEV-0 장애는 ChatGPT ImageGen 바이럴 출시 당시에 발생했다. 1주일 만에 1억 명 이상이 신규 가입하면서 쓰기 트래픽이 10배 이상 급증한 때였다.
내 서비스에 가져올 것과 그대로 따라 하지 않을 것
이 사례에서 복제본 개수보다 먼저 가져오고 싶은 것은 어떤 부하를 주 서버에서 덜어냈는지 확인하는 순서다.
읽기 비중이 높다는 판단도 API 요청 횟수만으로 내리기 어렵다. 한 요청이 실행하는 SQL 수와 비용, 쓰기 트랜잭션 안의 조회, 재시도까지 함께 봐야 한다.
예약 서비스를 검토한다면 기능마다 허용할 수 있는 데이터 지연과 쓰기 경쟁을 나눠 보겠다. 아래 표는 이 사례를 읽고 세운 적용 기준이며, OpenAI가 공개한 설정은 아니다.
| 기능의 요구 | 먼저 검토할 것 | 그대로 복제하면 생길 수 있는 문제 |
|---|---|---|
| 공개 상품 목록 조회 | 허용 가능한 데이터 지연과 캐시 만료 | 갱신 직후에도 예전 가격이나 재고가 보일 수 있음 |
| 방금 만든 예약 확인 | 쓰기 직후 읽기에서 최신 결과가 필요한지 | 복제 지연 때문에 예약이 없는 것처럼 보일 수 있음 |
| 마지막 좌석 확정 | 쓰기 트랜잭션·조건부 갱신·제약 조건 | 읽기 복제본을 늘려도 동일 좌석의 쓰기 경쟁은 해결되지 않음 |
| 일괄 데이터 보정 | 요청 지연과 DB 부하를 보며 작업 속도 제한 | 평소 빠른 작업이 피크 시간의 쓰기 여유를 소진할 수 있음 |
조인이 많다는 이유만으로 조인을 애플리케이션으로 옮기지는 않겠다. 먼저 생성된 SQL과 실행 계획을 확인한다. 나눴을 때 쿼리 횟수·전송량·일관성 비용이 늘어나는지도 비교해야 한다.
커넥션 풀링도 트랜잭션 단위로 연결이 바뀌어도 안전한지 확인한 뒤 고를 문제다. PgBouncer 기능 호환 표는 풀링 모드별 세션 기능의 제약을 구분한다.
따라서 이 글의 숫자는 용량 산정표 대신, 내 서비스에서 비싼 쿼리와 중복 쓰기를 먼저 찾는 질문 목록으로 쓰겠다.
“사용자가 몇 명까지면 샤딩이 필요 없다”는 기준은 측정 없이 정할 수 없다. 복제 지연, 쓰기 지연, 연결 대기, 캐시 실패 시 부하를 먼저 측정해야 한다.
정리
- 읽기 집약적 워크로드라면 단일 Primary PostgreSQL로도 예상보다 큰 규모를 감당할 수 있다.
- 샤딩 여부는 유저 수보다 실제 워크로드 패턴을 보고 정해야 한다.
- PostgreSQL의 MVCC 구조적 한계(Write Amplification, Bloat, Autovacuum)를 이해하고 설계에 반영해야 한다.
- ORM이 생성하는 SQL은 직접 검토해야 한다. 12개 테이블 조인이 자동으로 만들어질 수 있다.
- 캐시 락, Rate Limiting, 워크로드 격리, 타임아웃 설정을 여러 레이어에서 함께 적용해야 부하를 막을 수 있다.
참고: OpenAI의 PostgreSQL 확장 사례 (Bohan Zhang), The Part of PostgreSQL We Hate the Most (Andy Pavlo & Bohan Zhang)
2026-09-14 보완: 원문 링크와 수치의 범위, PostgreSQL 동작의 조건과 자체 적용 기준을 보완했다.